Arquitetura de software define as partes de um sistema, o papel de cada uma e como elas se comunicam. No backend, essas decisões pesam mais que qualquer framework, afinal são as mais caras de desfazer. Abaixo, explicamos o conceito e os 5 fundamentos que guiam essas escolhas: estado, comunicação, acoplamento, idempotência e cache.
Resposta rápida: arquitetura de software é a organização fundamental de um sistema, dentro de limites de prazo, orçamento e equipe. Ralph Johnson, em definição popularizada por Martin Fowler, resume o conceito como “o entendimento compartilhado que os desenvolvedores especialistas têm do design do sistema”. Na prática, ela decide quanto custa mudar, escalar e manter o software.
O que é arquitetura de software?
Pela norma ISO/IEC/IEEE 42010, arquitetura são os elementos de um sistema, suas relações e os princípios que guiam sua evolução. Na prática, a arquitetura de software cobre estas frentes:
- Partes: quais módulos ou serviços existem e o que cada um resolve.
- Comunicação: como essas partes trocam informação, por exemplo via HTTP, fila ou evento.
- Restrições: orçamento, prazo, tamanho do time e tecnologias disponíveis.
- Qualidades: metas como uma API que responde em até 200 ms no p95 (95% das requisições) e requisitos de segurança.
- Dados: onde ficam, quem acessa e com que consistência.
Por isso, desenhar caixas e setas é a parte menor do trabalho. Afinal, arquitetura é uma decisão de negócio tomada com ferramentas técnicas.
Onde começa e termina uma aplicação
A fronteira de uma aplicação muda conforme quem olha para ela. Veja a seguir o exemplo ilustrativo da home do Mercado Livre: cliente, desenvolvedor e negócio enxergam recortes diferentes.
Portanto, antes de discutir arquitetura, o time precisa combinar qual fronteira está em jogo. Caso contrário, cada pessoa defende uma solução para um problema diferente.
Por que a arquitetura de software importa?
Porque ela define quanto custa mudar, manter e escalar o sistema. Assim, uma fronteira mal traçada cobra juros em horas do time e na fatura da nuvem. Além disso, a complexidade cresce: o sintoma de um bug aparece num lugar, enquanto a causa mora em outro.
Da mesma forma, a arquitetura molda o trabalho em equipe. Para Melvin Conway, organizações que projetam sistemas são “obrigadas a produzir designs que copiam suas estruturas de comunicação”. De fato, a ideia de 1968 virou a Lei de Conway. Ela também vale ao contrário, na chamada manobra inversa de Conway: a arquitetura desejada passa a ditar quem conversa com quem.
Na prática, os casos públicos mostram o tamanho da conta. Em 2020, a Uber Engineering contou que agrupou cerca de 2,2 mil microsserviços críticos (serviços pequenos, cada um publicado separadamente) em 70 domínios. Antes, investigar um problema podia exigir passar por uns 50 serviços de 12 times. Com isso, um time pioneiro reduziu de três dias para três horas o tempo de integrar uma feature.
A Shopify fez o caminho oposto. Em 2020, a Shopify Engineering contou que seu monolito (um sistema único, publicado de uma vez) tinha 2,8 milhões de linhas de Ruby. Na época, ele já estava dividido em 37 componentes, num processo ainda em andamento. Assim, a empresa buscou fronteiras claras sem multiplicar deploys (publicações de nova versão) e chamadas de rede. Já o Prime Video, em março de 2023, juntou num único processo um serviço de monitoramento. Antes, ele rodava espalhado em componentes serverless. Segundo o próprio time, o custo de infraestrutura caiu mais de 90%.
Mesmo assim, microsserviços seguem populares. Segundo o CNCF e a SlashData, 39% dos desenvolvedores backend usavam microsserviços no primeiro trimestre de 2026. Nossa visão, portanto, é que não existe estilo vencedor. Existe o trade-off certo para cada contexto, e o que serve à Uber pode afundar uma startup de cinco pessoas.
Publicidade
Arquitetura x design de código: qual a diferença?
A arquitetura define as fronteiras de execução e deploy; o design define as fronteiras de responsabilidade dentro do código. Na dimensão estrutural ficam os tipos de arquitetura de software mais citados: monolito, microsserviços e event-driven, além de modelos de execução como serverless. A escolha de onde hospedar também entra aqui.
Já na dimensão de design ficam Clean Architecture, hexagonal, onion e MVC. Esses padrões organizam as dependências dentro de um mesmo serviço. Na prática, a linha entre os dois níveis é borrada, e o critério mais útil é quanto custa desfazer a decisão.
Veja a seguir o mesmo sistema de pagamentos nos dois níveis. Primeiro, no estrutural, a Cobrança é um serviço com deploy próprio que recebe mensagens das Matrículas por uma fila. Em seguida, no de design, a regra de cobrança depende da interface GatewayPagamento, e cada provedor entra como um adapter.
Repare, portanto, que as duas decisões são independentes. Assim, dá para ter um monolito com design hexagonal impecável e, da mesma forma, microsserviços com regras emaranhadas por dentro. Para aprofundar o design, sugerimos começar pela arquitetura hexagonal e pela Clean Architecture. Ambas dependem do bom uso de interfaces, um conceito da programação orientada a objetos.
Stateless ou stateful? Síncrono ou assíncrono?
Stateless escala com facilidade, enquanto stateful mantém o contexto vivo na instância. Da mesma forma, síncrono responde na hora e assíncrono aceita agora para entregar depois.
Stateless ou stateful: quem lembra de você?
Num serviço stateful, a continuidade depende de um estado guardado na memória da instância. No stateless, por outro lado, cada requisição traz tudo de que precisa, como um token. Pense num crachá: no stateless você o mostra em cada porta, enquanto no stateful o segurança já te conhece.
Repare que stateless não quer dizer sem estado. O estado só sai da memória da instância e vai para um banco ou um Redis compartilhado. Assim, até um cookie de sessão funciona, desde que a sessão fique fora da instância.
Por isso, consideramos stateless o ponto de partida mais seguro para APIs, e uma API REST é stateless por definição. Ainda assim, stateful faz sentido num jogo multiplayer em tempo real. Nesse caso, o estado da partida vive na instância e o jogador fica preso a ela. Logo, não existe regra fixa: existe decisão.
Síncrono ou assíncrono: precisa da resposta agora?
A pergunta-chave é se o usuário precisa do resultado agora e se dá para produzi-lo agora. Por exemplo, a análise de documentos num serviço terceiro (foto da CNH + selfie) pode levar até 30 minutos. Logo, nenhum timeout razoável de HTTP aguenta essa espera. Por isso, a API grava o pedido numa fila, responde 202 Accepted com um link para consultar o status e avisa o usuário depois.
O 202 existe justamente para isso: pedido aceito, mas ainda não processado. Se a análise falhar várias vezes, a fila move o pedido para uma fila de mensagens mortas (DLQ). Além disso, o mesmo raciocínio vale entre duas APIs, quando uma depende de um processamento lento da outra.
Publicidade
Acoplamento, idempotência e cache: onde os bugs se escondem?
Os bugs mais caros de arquitetura costumam nascer de dependências ocultas, mensagens duplicadas e dados velhos servidos pelo cache. Abaixo, cada um vem com a pergunta que ajuda a evitá-lo.
O que é acoplamento?
Acoplamento é o grau de dependência entre duas partes. Na prática, o teste é simples: se eu mudar B, o que muda em A? Por exemplo, a matrícula esperar a cobrança confirmar o pagamento para liberar o curso é legítimo. De fato, essa dependência nasce de uma regra de negócio. Contudo, ela só é saudável enquanto se limita ao status. Nesse intervalo, a tela só precisa avisar que o pagamento está em confirmação.
Portanto, o sinal de alerta é uma falha numa parte derrubar outra sem nenhuma razão de negócio entre elas.
O que é idempotência?
Uma operação é idempotente quando repeti-la produz o mesmo efeito de executá-la uma vez só. Filas e webhooks costumam entregar cada mensagem pelo menos uma vez (at-least-once), então a pergunta é: e se essa mensagem chegar duas vezes? Por isso, a saída mais usada é uma chave de idempotência que viaja junto com a mensagem.
- 1A cobrança publica o eventoPagamentoConfirmado chega com a chave
pay_7f3a9c, gerada uma única vez por pagamento. - 2A matrícula consulta a chaveEssa chave já foi processada antes?
- 3Primeira vez: processaLibera o curso e grava chave + resultado na mesma transação.
- 4Repetição: só confirma a mensagemO curso já está liberado, então nada acontece de novo.
E se as duas cópias chegarem ao mesmo tempo? Uma restrição UNIQUE na coluna da chave garante que só uma grava.
No entanto, a chave não é bala de prata. O consumidor ainda precisa gravar o resultado com segurança e tratar chamadas concorrentes. Em APIs HTTP, a mesma ideia vira o cabeçalho Idempotency-Key: o cliente repete o POST e recebe a resposta salva. O guia de API REST mostra quais métodos HTTP já nascem idempotentes.
Cache: quanto atraso o dado aguenta?
Cache troca frescor por velocidade e economia, então a pergunta é quanto tempo o dado pode divergir da fonte da verdade. Por exemplo, uma consulta que leva 1 segundo no banco pode voltar em poucos milissegundos da memória. Por outro lado, o cache pode servir dado velho. Se um cliente recebe um Pix de R$ 10 mil e o app mostra saldo zerado, o resultado é pânico.
Num post de blog, em contrapartida, atraso de minutos ou horas é aceitável. No próprio techknow, por exemplo, cada post fica em cache até ser editado. Quando o texto muda, um webhook invalida só aquela página, que é regenerada na visita seguinte. O guia de estratégias de cache no Next.js detalha essa técnica.
Por onde começar a estudar arquitetura de software?
Comece pelas cinco perguntas deste guia, e não por uma lista de tecnologias. São elas que transformam execução em decisão técnica:
- Estado: onde fica a sessão do usuário?
- Comunicação: a resposta precisa ser imediata?
- Acoplamento: se eu mudar esta parte, o que quebra?
- Idempotência: e se a mensagem chegar duas vezes?
- Cache: quanto atraso o dado aguenta?
Para praticar, monte a dupla matrícula e cobrança deste guia, com fila, 202 e evento com chave de idempotência. Vale em Node, Go ou num primeiro projeto Spring Boot. Depois, aprofunde a modelagem de domínio com DDD. Se quiser montar uma trilha de leitura, nossa seleção de livros de programação organiza as opções por nível.
Por fim, nenhuma dessas respostas é definitiva. A arquitetura de software precisa ser revisitada a cada mudança de escala, de time ou de negócio.
Publicidade
Um livro para aprofundar
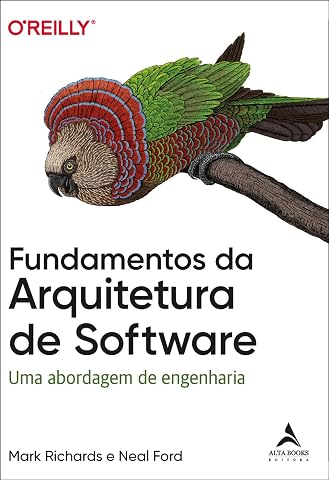
Para a teoria, recomendamos Fundamentos da Arquitetura de Software, de Mark Richards e Neal Ford. De fato, a Primeira Lei do livro resume a disciplina: “tudo em arquitetura de software é um trade-off”. Além disso, a obra compara estilos como camadas, microsserviços e event-driven com critérios claros de escolha.

Este artigo contém links de afiliado. Se você comprar por eles, podemos receber uma comissão, sem custo extra para você.